
Od té doby, co ChatGPT způsobil revoluci v umělé inteligenci tím, že ukázal sílu architektury transformer při generování textu, byla tatáž architektura úspěšně přizpůsobena celé řadě použití: od obrázků po video. Dosud se ale nikomu nepodařilo využít její sílu k porozumění sportu, protože chyběl dostatečně obrovský dataset, na kterém by se dalo trénovat.
Pro fotbal jsme tuto mezeru právě zaplnili.
Problém: každá nová statistika potřebuje vlastní AI trénovanou od nuly
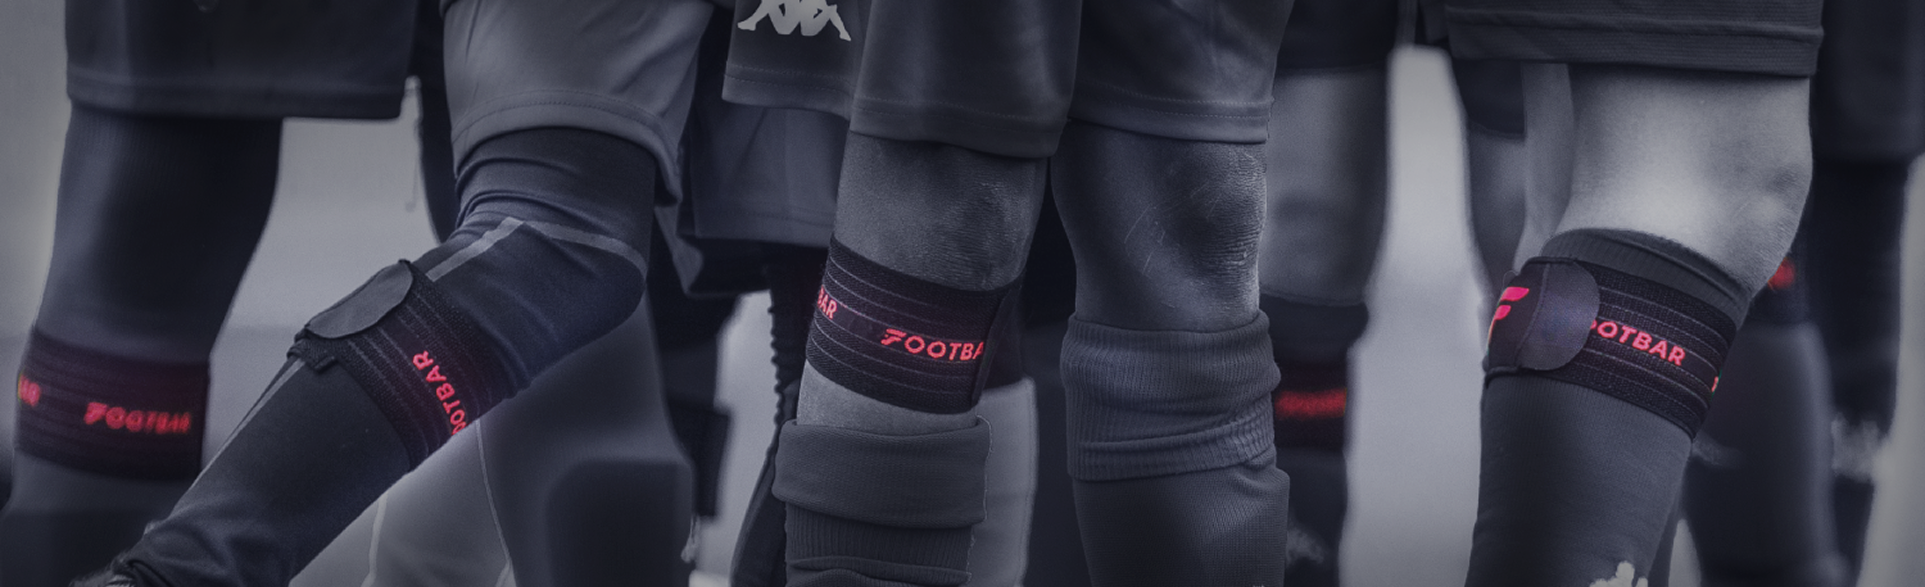
Díky nasazení technologie Footbar nosí každý hráč na noze malý Tracker, který měří zrychlení: jak se noha pohybuje, 50krát za sekundu, po celý zápas. Z tohoto surového signálu získáváme statistiky: kopy, šprinty, uběhnutou vzdálenost, rychlost běhu a další.
Dosud každá nová statistika znamenala vytvoření zbrusu nového AI modelu, natrénovaného od začátku, jen pro tuto jednu úlohu. A k natrénování dobrého modelu jsou potřeba označená data: skutečné zápasy, u kterých někdo ručně prošel záznam a sekundu po sekundě označil „tohle je kop“, „tohle není“. To je pomalé, drahé a musí se to opakovat pokaždé, když chceme změřit něco nového.
Co jsme vytvořili: jeden AI „mozek“, který už rozumí fotbalovému pohybu
Místo trénování nového modelu pro každou statistiku jsme vytvořili TransMTR: jediný AI model natrénovaný jednou na pohybových datech z více než milionu fotbalových zápasů a tréninků; pravděpodobně jde o největší databázi pohybu těla specifického pro fotbal, jaká kdy byla sestavena.

A tady je trik, díky kterému to funguje jako ChatGPT: nepotřebovali jsme, aby někdo ručně označoval tento milion zápasů a tréninků. Model se obecné „gramatice“ fotbalového pohybu naučil sám, stejně jako se ChatGPT učí gramatiku jazyka pouhým čtením obrovského množství textu, aniž by učitel hodnotil každou větu.
Jakmile je model natrénovaný, je zmrazený: znovu ho netrénujeme. Jen tam stojí jako opakovaně použitelný základ a na něj se pro každou konkrétní statistiku, kterou chceme, připojují malé, lehké moduly.
Výsledek: přesné statistiky s mnohem menším ručním označováním
Tady to začíná být zajímavé pro trenéry i hráče. Tento základní model jsme otestovali na dvou velmi odlišných úlohách: detekci kopů (diskrétní událost) a odhadu rychlosti běhu (spojité měření) a porovnali jsme ho s tradičním modelem natrénovaným postaru, od nuly, na stejné úloze.
U detekce kopů, když jsme oběma modelům dali jen nepatrné množství ručně označených dat (asi 1 % toho, co se běžně potřebuje), tradiční model v podstatě jen hádal, zatímco náš základní model už podával silný výkon, protože se z masivního předtrénování na neoznačených datech už naučil, jak fotbalový pohyb vypadá.
U rychlosti běhu je to trochu nuancovanější: s velmi malým množstvím označených dat podávaly oba přístupy podobný výkon a tradiční model se dostal do vedení, jakmile dostal celý označený dataset. Našli jsme ale jednoduché řešení: místo aby doplňkový modul základního modelu posuzoval rychlost z jediného okamžiku, necháme ho krátce nahlédnout na pár sekund kolem tohoto okamžiku, podobně jako trenér nebude posuzovat něčí rychlost běhu z jediného zmrazeného snímku. S touto malou změnou náš zmrazený základní model tradiční přístup dohnal a potom i překonal, aniž bychom kdy museli znovu trénovat samotné jádro modelu.

Proč je to důležité pro tebe
Pro hráče a trenéry to není jen technický detail: mění to, jak rychle a jak spolehlivě se nové poznatky dostanou na hřiště:
- Nové statistiky, rychleji. Protože ta těžká část (porozumění surovému pohybu) je už vyřešená, přidání nové metriky už nevyžaduje sbírat a označovat tisíce zápasů od nuly.
- Konzistentnější čísla. Zjistili jsme také, že tento přístup dává od běhu k běhu mnohem stabilnější výsledky než tradiční metoda: méně překvapení, důvěryhodnější srovnání z jedné sezóny na druhou.
- Postaveno na reálných datech z přirozeného prostředí. Žádné laboratorní podmínky ani vybrané sestřihy nejlepších momentů: přes milion skutečných zápasů a tréninků z amatérského a základního fotbalu z celého světa, ze stejného prostředí, ze kterého pocházejí i tvé vlastní statistiky.

Přečti si celou studii
Tento příspěvek na blogu je zjednodušené shrnutí. Všechny technické podrobnosti: architekturu, nastavení tréninku, statistické výsledky a omezení, najdeš v kompletním článku: